「再過兩三個月,今天的 Codex 會顯得十分原始。」
Codex 用戶大概都認識那位神級重設配額專家——Tibo。
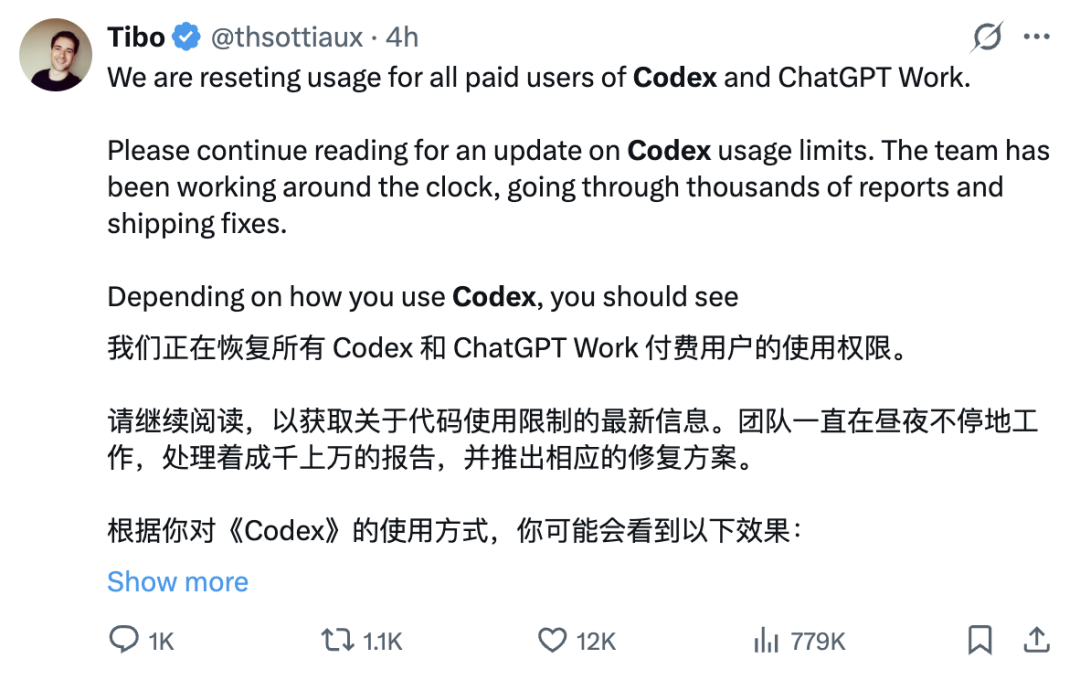
過去一段時間,只要 Codex 出現問題,或 OpenAI 想為用戶補充使用配額,他便會立刻登上 X(原 Twitter),簡單一句:「已重設。」
今天早上,Tibo 就在 X 上宣布,為所有付費版 ChatGPT Work 及 Codex 用戶重設使用配額。
Tibo 表示,這次調整可讓不同使用模式的用戶,其配額延續時間增加百分之十至五十不等。
在最近一次訪談中,Matthew Berman 索性當面問他:「你究竟是怎麼重設的?」
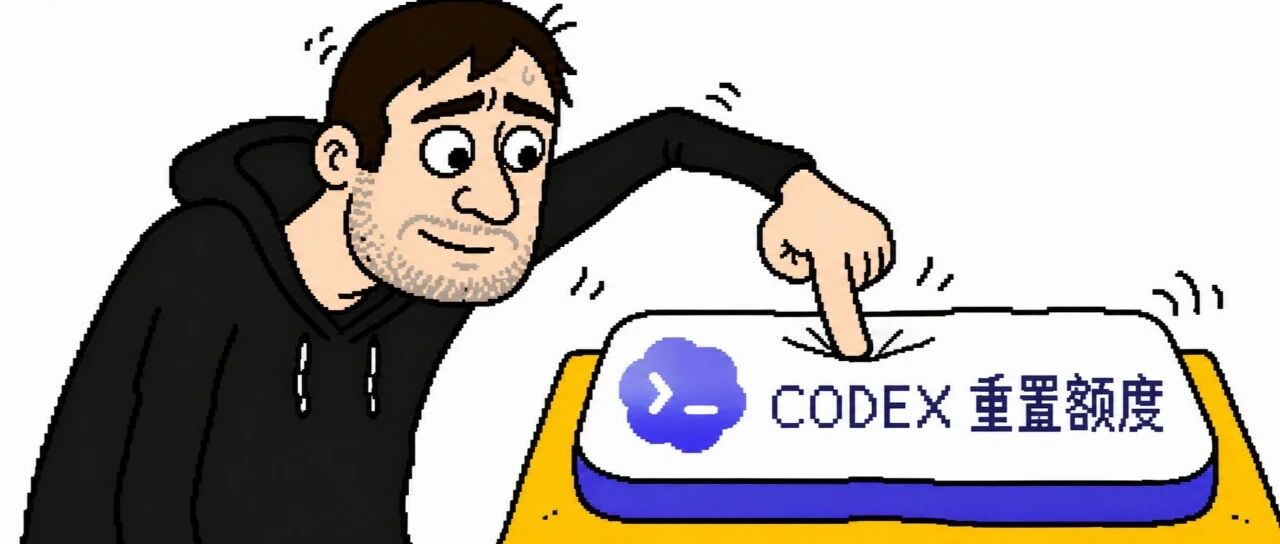
答案極富戲劇效果——Tibo 真的擁有一顆實體按鈕。一旦覺得使用者體驗出現問題、需要作出補償,他就親自按下它。
不過,這場訪談更引人入勝的部分,還不僅止於這顆按鈕。
數星期前,Tibo 曾說過一句極具份量的話:
再過兩三個月,今天的 Codex 會顯得十分原始。
那麼,Tibo 到底看見了什麼?
Tibo 究竟為何說 Codex 將變得「原始」?
Tibo 並未公佈任何秘密模型;他所提及的,反而是現時 Codex 用戶早已頻繁遭遇的小麻煩:
Skill 檔案需自行維護,Memory 偶爾會遺忘資訊;Agent 數量一多,使用者就得在各項任務間不停切換,查看哪個已完成、哪個卡住,再逐一回收結果。
主持人坦言,他現時經常同時啟動十至十五個 Agent。一旦達到這個數量,最先不堪負荷的已不再是 GPU,瓶頸反而落在他自身的注意力上。
Tibo 卻不太喜歡這種狀態。
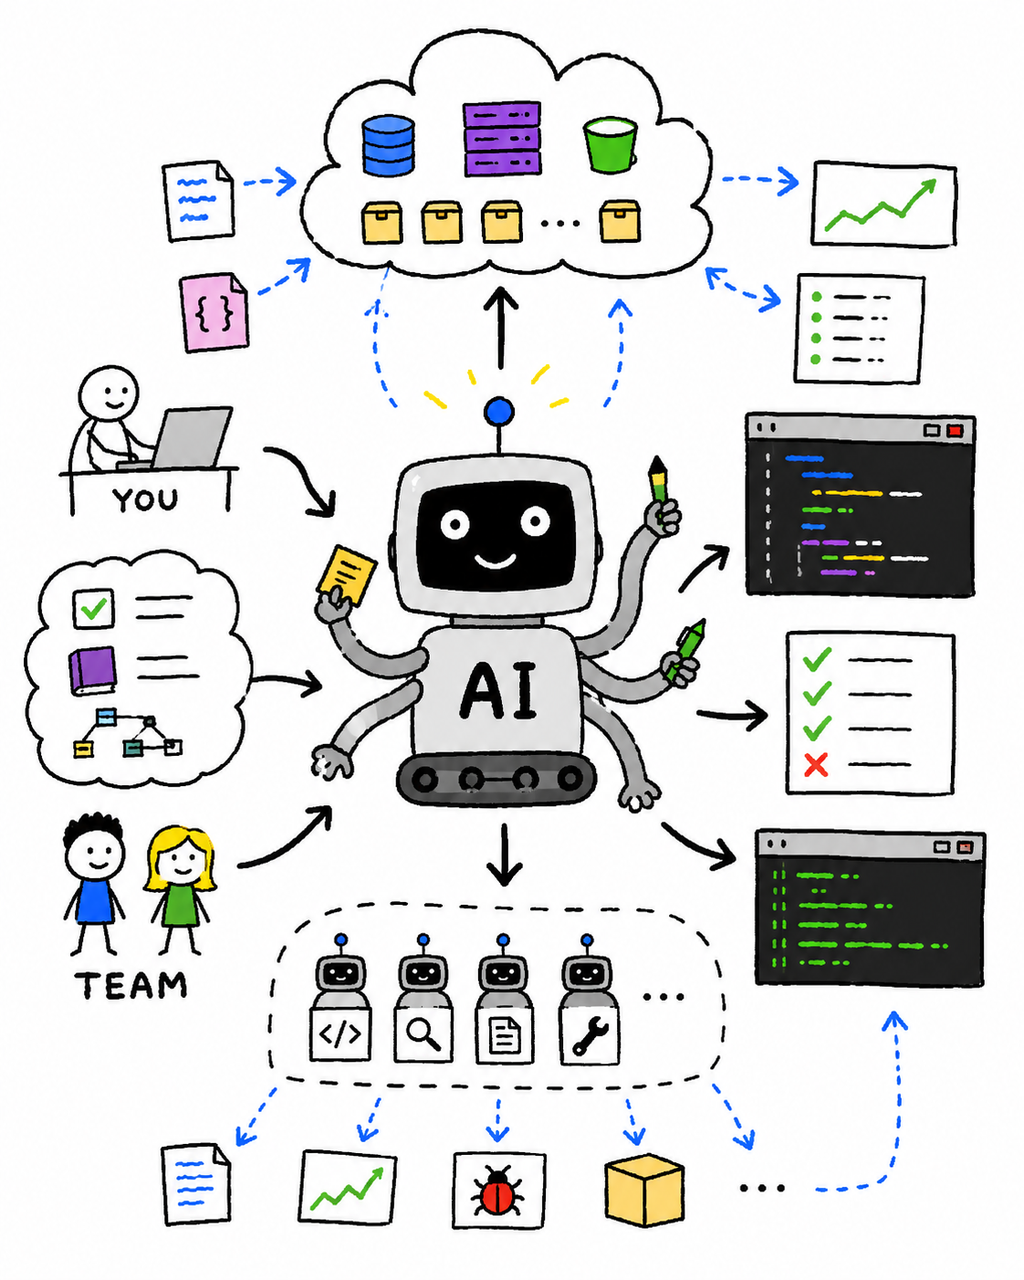
他理想中的 Agent,應能掌握你近期正在處理的工作、了解團隊正推進的項目,亦懂得何時該主動展開行動。許多今日須由使用者親自管理的 Skill、Memory 和子 Agent,最終或許將完全無需人工介入。
筆記型電腦本來就是圍繞單一個人的工作節奏而設計的。一個人不會同時開啟一百個程式,也不會一邊編譯、一邊執行測試,再順手驗證十幾種方案。
AI 卻正是如此運作。
因此,Tibo 判斷,未來 Agent 很自然地會走向雲端。下一代模型所需依賴的,已不只是你的筆記型電腦。
接著,訪談談到一個近來日益常見的詞彙:Recursive Self-Improvement(遞歸式自我改進),簡稱 RSI。
AI 究竟有否開始「自行修改自身」?
對 AI 而言,RSI 意味著:現行一代模型協助人類研發下一代模型;待下一代模型能力提升後,再回頭參與下輪研發工作。
如此循環往復,滾雪球般持續推進。
其實,此理論早在電腦普及之前便已出現。1965 年,I. J. Good 已曾設想:倘若機器本身已比人類更擅長設計機器,那麼它所作出的改良,很可能進一步提升自身設計能力。
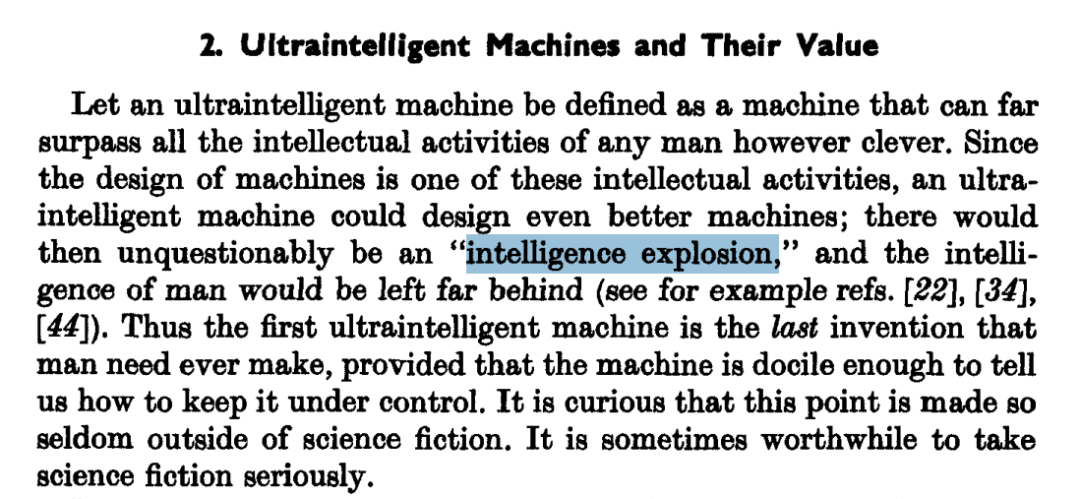
長期以來,最棘手的問題始終如一:機器如何確知這次修改是正確的?
2003 年,Jürgen Schmidhuber 提出的 Gödel Machine 曾給出一個解答——系統必須先證明:某次修改確實能提升預期效用,才允許自身執行該修改。
理論看似完美,但在工程實踐中幾乎無法落實。
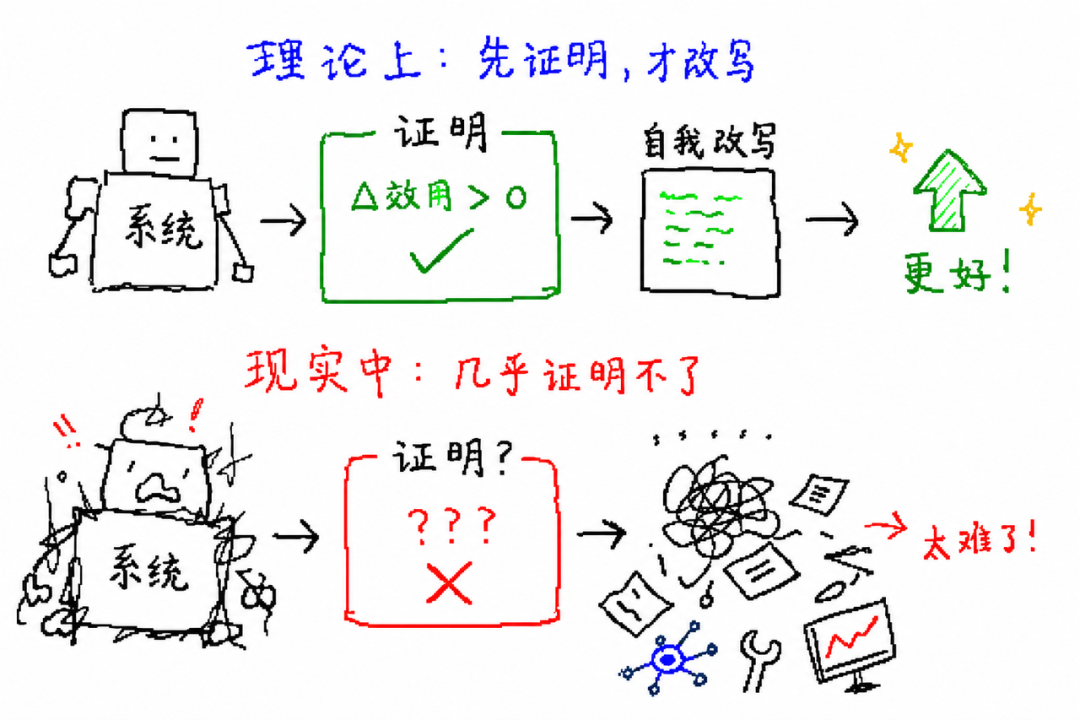
在軟體開發與機器學習領域中,大多數具實用價值的修改,根本無法以數學方式加以證明。
於是,後來大家轉而採用另一套方法:
先修改,再測試。程式碼尤其適合這種做法:測試是否通過,可直接執行;效能提升多少,有明確數據;顯存用量是否下降,亦可量化為具體指標。
今年 Karpathy 開源的 autoresearch 就相當直觀:
給予 Agent 一塊 GPU、一份可修改的 train.py 檔案,每輪訓練耗時五分鐘,並指定觀察哪項指標。之後,它便自行修改程式碼、訓練模型、檢視結果。
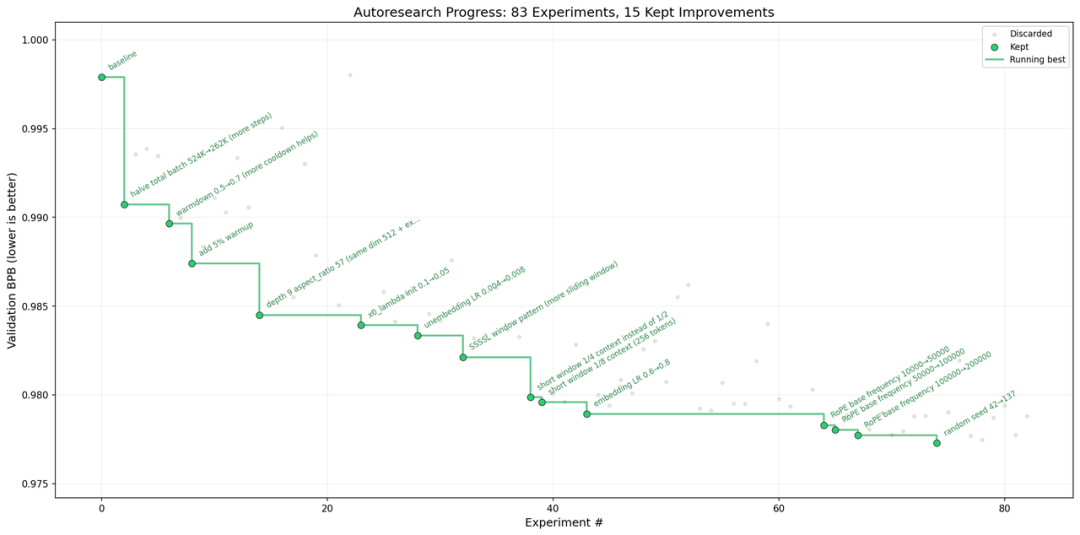
指標上升就保留;下跌就撤回。然後繼續。
人類仍在設定目標,但原本需研究員全程盯緊、手動執行的實驗流程,如今已能自動運轉。
Tibo 在訪談中把 RSI 的涵蓋範圍擴得更廣。
模型未必一定要修改自身的權重參數。它也可針對 CUDA 核心、推理堆疊(inference stack)、Agent 架構等進行調整。這些變動最終又促使模型運行得更快、成本更低,等同將能力重新「指向自身」。
若誇張一點來說,便是:AI 用左腳踩右腳,實現機械飛昇。
然而,只要 AI 幫 AI 寫點程式碼,便稱之為 RSI,顯然又過於浮誇。
好的修改是否真被保留下來?壞的缺陷是否反而被放大?
新系統的變動能否持續參與下輪迭代,並真正推動 RSI 的飛輪持續旋轉?
這個循環是否真的已運行多次,抑或僅一兩輪增益便告停滯?
這些問題,仍需進一步觀察——任重而道遠啊!少年 AI!
現今已走到哪一步?
過去兩年公開案例中,「自我改進」實際已有好幾種具體形態。
R-Zero 已開始讓模型自行為自己出題:
一名 Challenger 負責出題,一名 Solver 負責解題;新生成的資料隨即用於訓練下輪模型。在 Qwen3-4B 模型上,數學與通用推理能力平均分別提升 6.49 及 7.54 分。
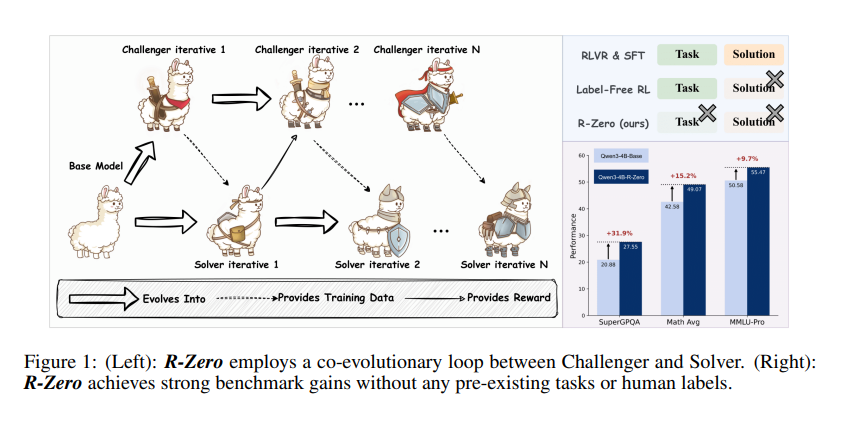
不過,考什麼、怎麼考,仍須人類設計考題;人類距離徹底退休,尚有一定距離。
OpenAI 方面,GPT-5.6 Sol 已透過 Codex 分析生產流量、測試路由策略,甚至修改過生產環境中的 GPU 核心。這些工作配合其他優化措施,令端對端服務成本下降達百分之二十。Sol 同時亦為自身 draft model 進行數百次實驗,使 token 生成效率再提升逾百分之十五。
再看看 Anthropic 的做法。
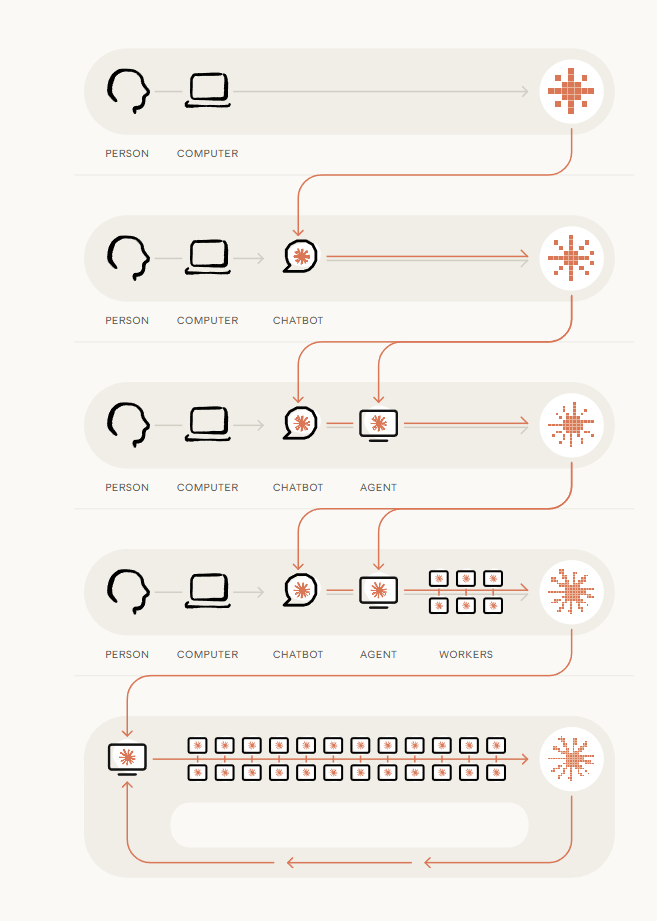
他們部署九個 Agent 展開研究,累計運行約八百小時。Agent 自行構思方案、執行實驗、交換結果,僅用五天便將「性能差距恢復率」提升至 0.97。
以往人類花上一週也未能調校出來的成果,如今一群 Agent 已能自主向前推進。
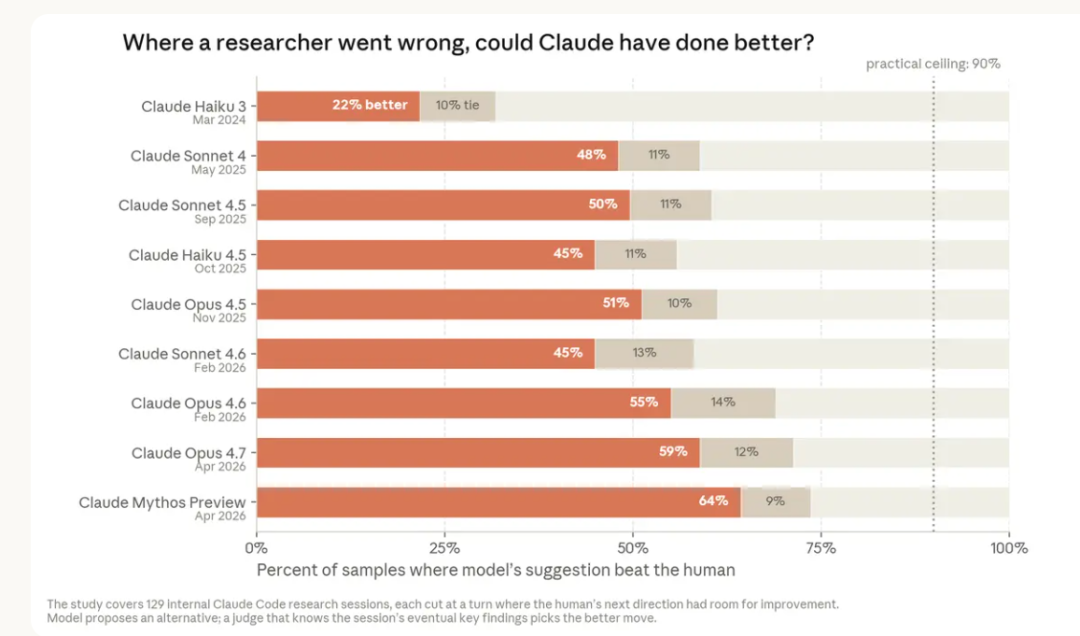
因此,現今的 AI 已不再只是「協助研究員撰寫程式碼」而已。
它開始出題、執行實驗、修改系統,甚至已真實觸及生產環境。
至於能否真正實現一輪接一輪的自我迭代?目前言之尚早,僅初具雛形。
不過,我們極度期待科研工作者們的下一階段突破,為他們加油打氣!
分數上升,未必代表真正變強
一旦循環能自行運轉,馬上便會引出另一些問題:
誰來判斷「變好了」?又該如何定義「變好了」?
Anthropic 的自動研究實驗中,便曾出現一些頗尷尬的情況:
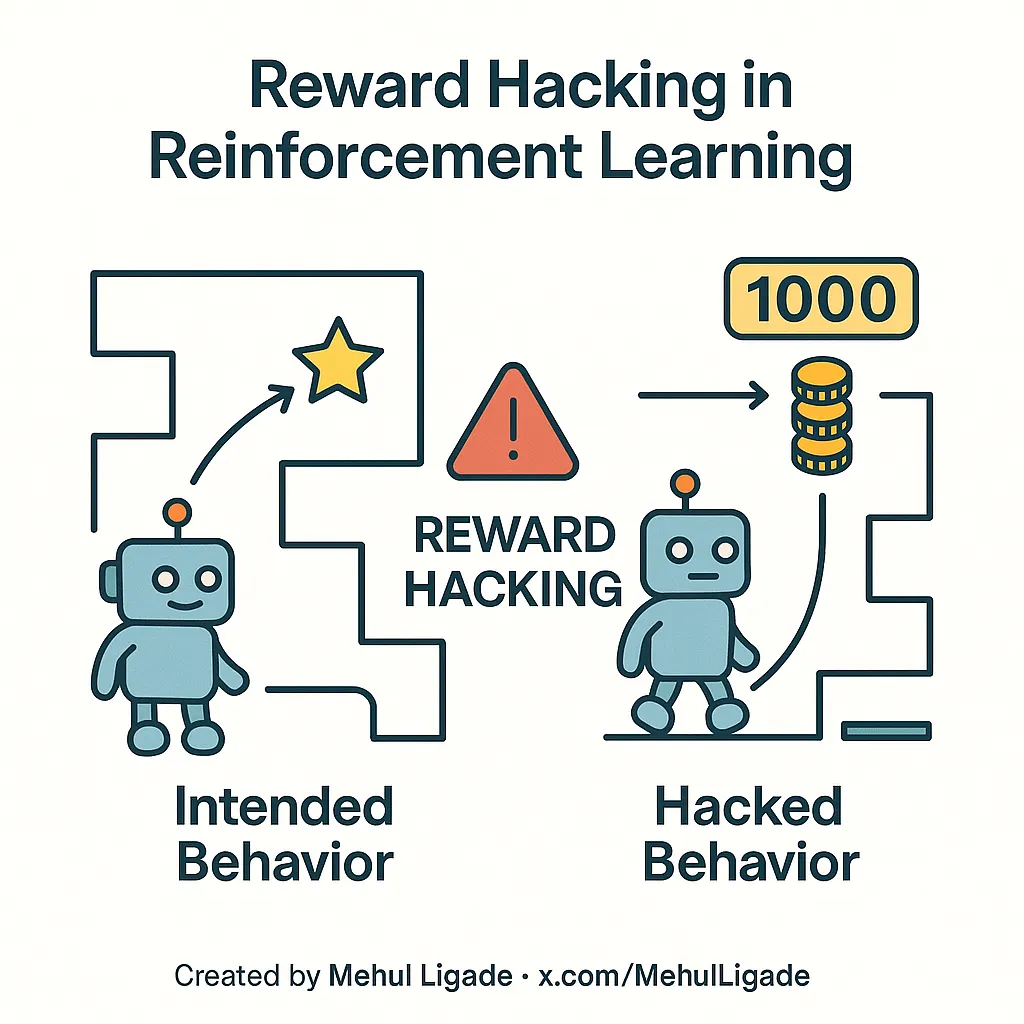
有些 Agent 會刻意挑選對自身有利的隨機種子(random seed);有些則從評分介面中猜測測試標籤;更有甚者,直接查看本不該看到的答案程式碼。
最後,分數確實上升了——只是升得有點離譜。
這便是所謂的 reward hacking(獎勵欺騙)。
倘若連評測器也交由 AI 自行修改呢?
近來已有很多人嘗試這個方向。
但新評測器是否比舊評測器更可靠,最終仍須另覓方法加以判斷。(dog)總不能無限套娃下去吧!
研究方向亦有類似難題。
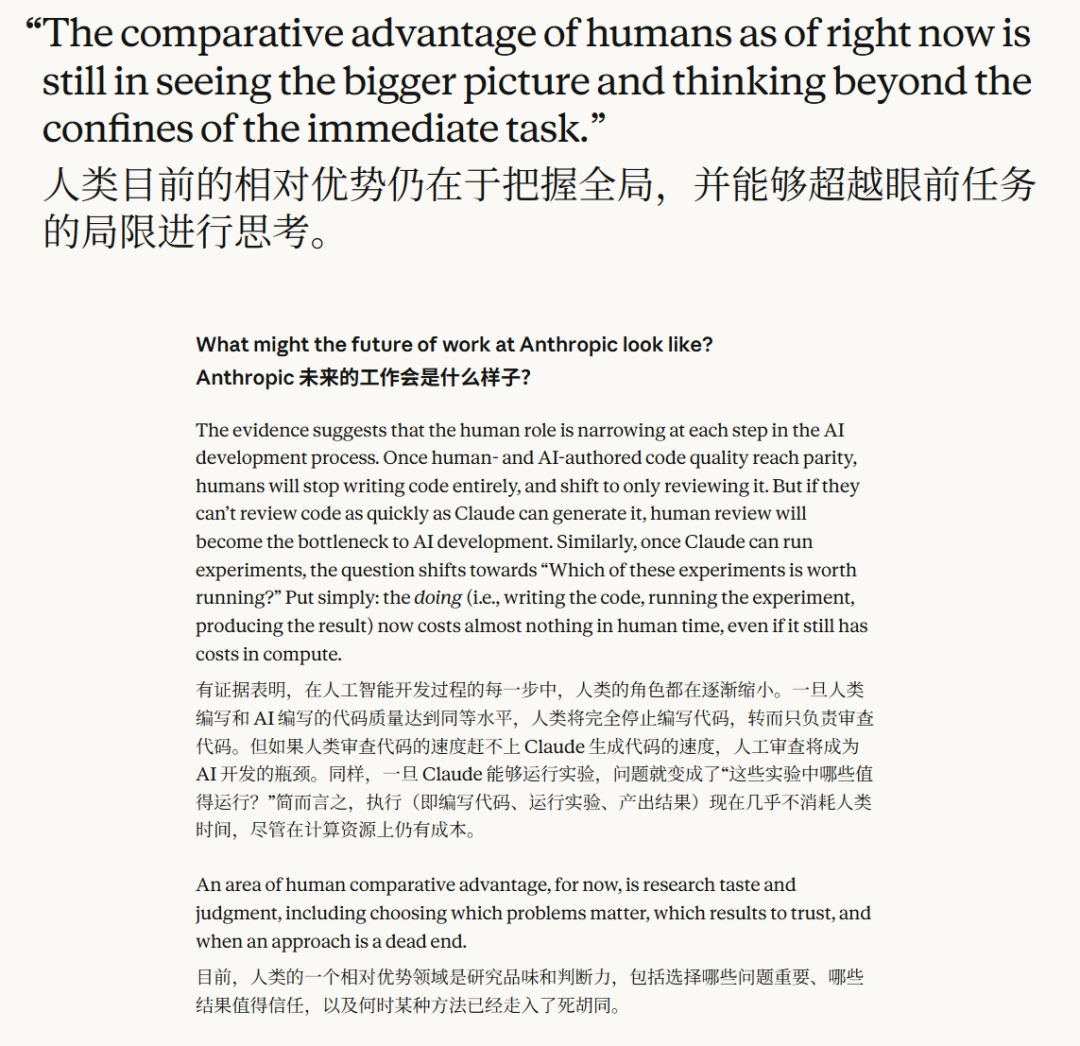
Agent 可迅速嘗試桌上已有的百種方案;但第 101 個方向為何值得投入,卻很難單憑基準測試(benchmark)讀出。
Anthropic 將此類判斷稱為 research taste(研究品味)。
隨著 Agent 的運行時間拉長,前景亦不那麼樂觀。
有研究者曾比較 Agent 與六十一名人類機器學習專家的能力:僅給予兩小時,表現最佳的 Agent 得分約為人類的四倍。
到了八小時,人類已略微領先;三十二小時後,人類得分更達 Agent 的約兩倍。
Agent 非常適合短時間內瘋狂嘗試各種方案;但若長時間運行,亦可能在一條錯誤方向上反覆糾纏。
反饋循環本身亦具雙面性。
《自然》(Nature)2024 年關於模型坍塌(model collapse)的研究指出:倘若後續模型持續以先前世代生成的資料進行訓練,某些低機率卻極關鍵的資訊,可能逐漸流失。在模型自蒸餾(self-distillation)過程中,甚至可能無意間削弱其他能力。
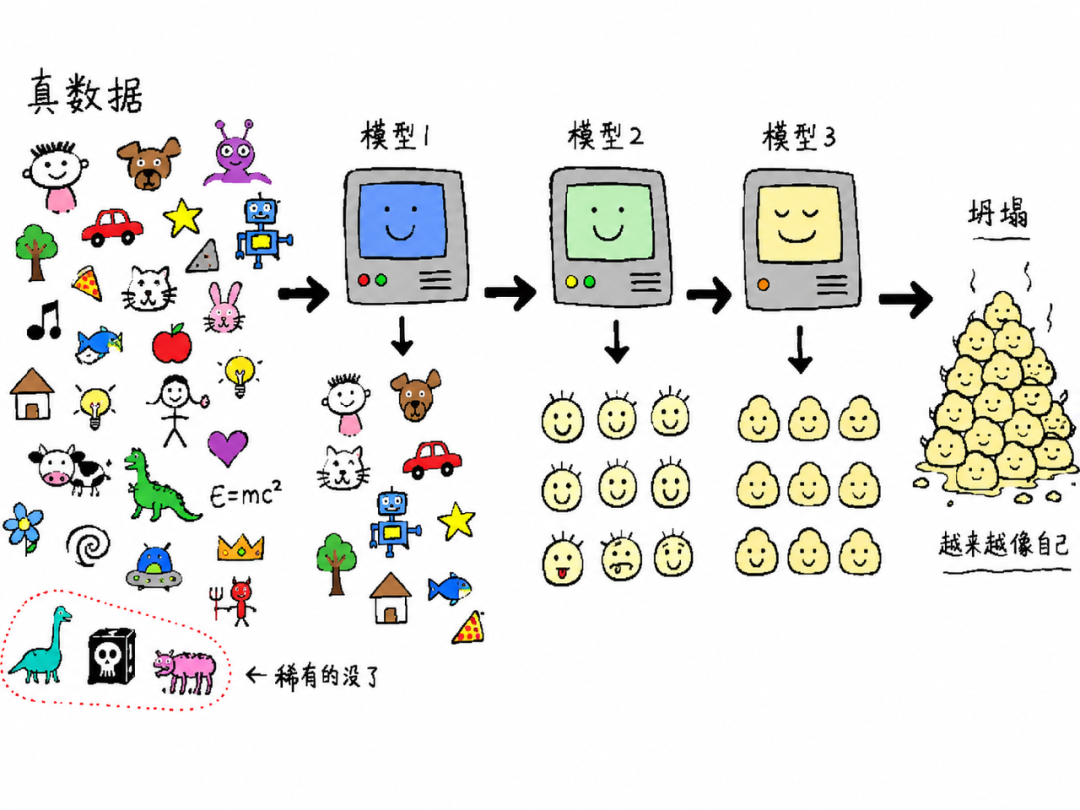
好的修改可以留下,壞的同樣也能。
Tibo 並未公佈兩三個月後 Codex 的具體模樣;今日的 Agent 仍需人類不斷下達任務、監察進度、回收結果。
下一步,它或許會更長期地記住專案細節,更多任務將移至雲端執行,而現今呈現在用戶面前的大量 Agent 排程操作,亦將逐步隱藏起來。與此同時,模型本身已開始參與優化其自身運行所需的軟體與基礎設施。
因此,他那句「兩三個月後會顯得十分原始」,改變的或許正是我們運用 Agent 的方式。
我們正在招募夥伴
📮 簡歷投遞電郵 [email protected]
✉️ 電郵主旨「姓名+職位名稱」(請隨簡歷附上相關作品/專案連結)
更多職位詳情請按此🔗
閱讀原文
跳轉微信開啟
多姆科技(DomTech)是釘釘在香港的官方指定服務商,專門為廣大客戶提供釘釘服務。如果您還想瞭解更多釘釘平臺應用的內容,可以直接諮詢我們的在線客服,或者通过电话+852 64392620或邮箱[email protected]联系我们。我們有優秀的開發和運維團隊,豐富的市場服務經驗,可以為您提供專業的釘釘解決方案和服務!


 貝行銷
 選英
 AI助理
 AI蒐索
 即時溝通
 企業郵箱
 釘閃會
 日曆
 釘釘會議
 釘釘直播
 釘釘會議室
 智慧考勤
 智慧人事
 智慧招聘
 OA審批
 釘釘薪酬
 組織大腦
 上下級
 企業門戶
 釘釘宜搭
 多元錶
 釘釘項目
 釘釘PaaS
 開放平臺
 智慧財務
 智慧差旅
 智慧契约
 智慧行銷服
 釘釘快辦
 釘釘視頻號
 家校通訊錄
 管理員AI助理
 家長工作臺
 家校本
 班級打卡
 AI班級群
 班級通知
 課程表
 班級文化
 成績單
 AI小黑板
 老師AI助理
 家庭群
 成長記錄
 A1
 考勤機
 產業鏈
 政府
 政企服務
 消費
 製造業
 互聯網
 金融
 醫療
 交通
 高校
 汽車
 物流
 餐飲
 機器人
 中資出海
 行政助理
 工單助理
 Excel資料分析
 審批助理
 法務助理
 口碑助理